To view all my publications, please refer to google scholar
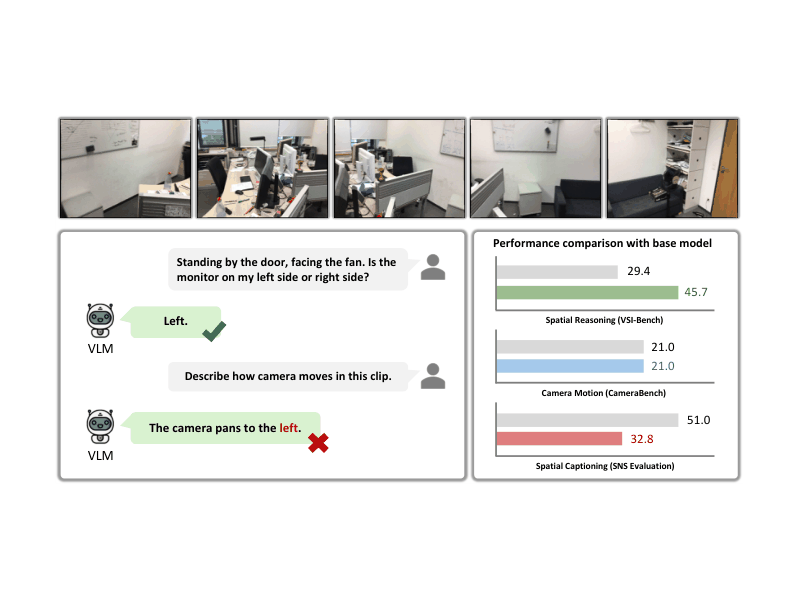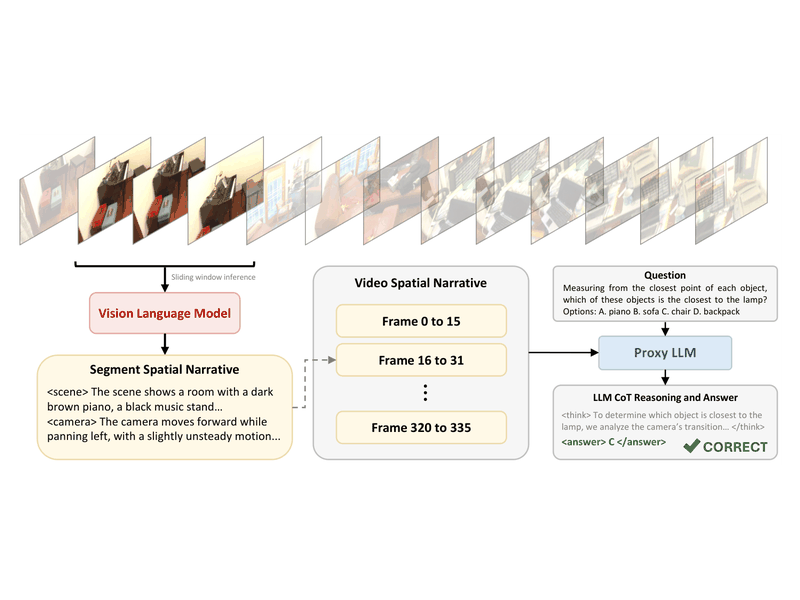 CaMo: Camera Motion Grounded Evaluation and Training for Vision-Language Models
British Machine Vision Conference (BMVC) Oral, 2026.
Hsiang-Wei Huang, Junbin Lu, Kuang-Ming Chen, Jianxu Shangguan, Cheng-Yen Yang, and Jenq-Neng Hwang.
[ArXiv] [Code] [Model]
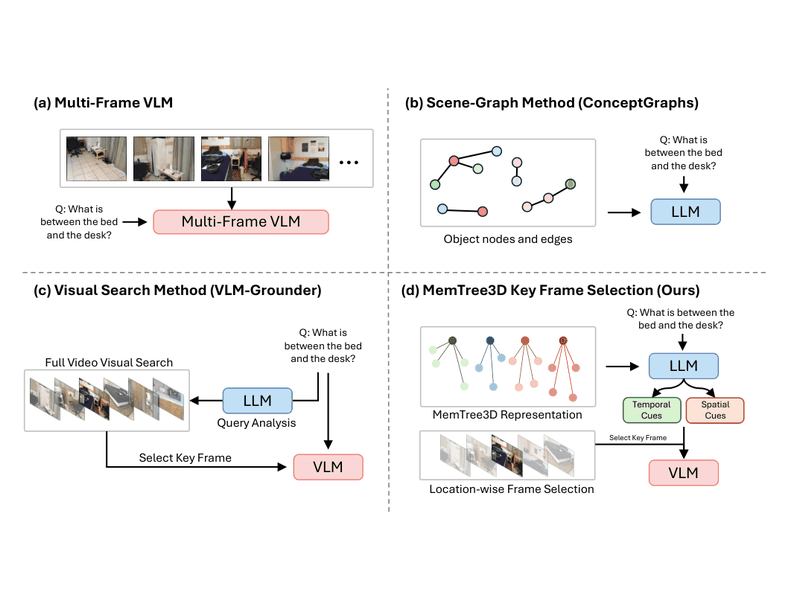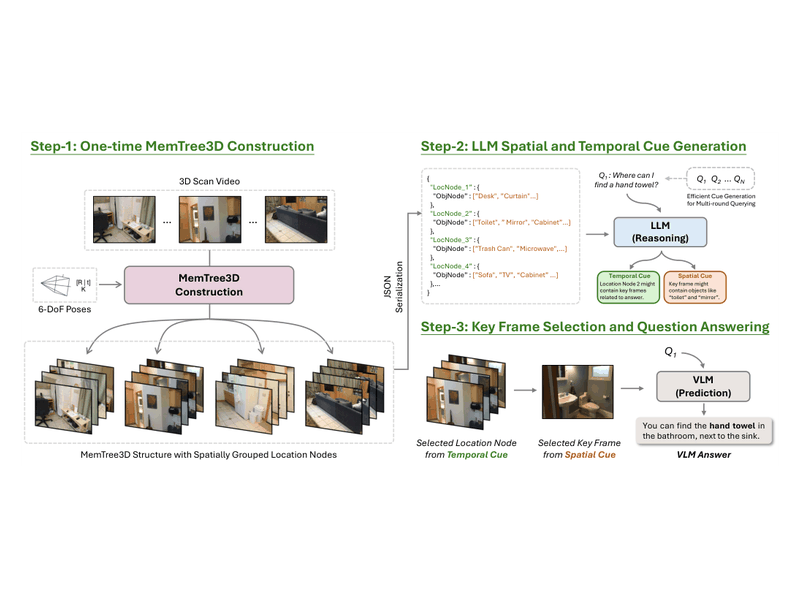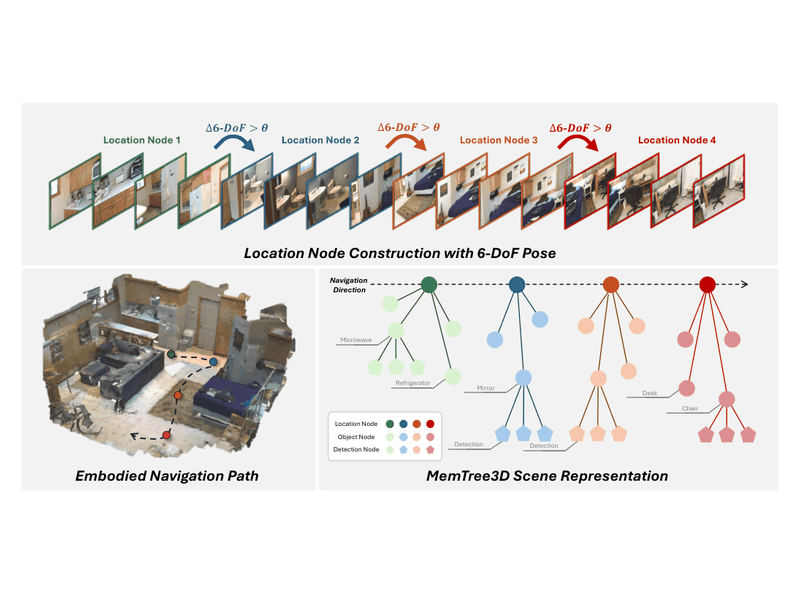 Memory Tree Guided Key Frame Querying for Efficient 3D Question Answering
European Conference on Computer Vision (ECCV), 2026.
Hsiang-Wei Huang, Fu-Chen Chen, Li-Wu Tsao, Cheng-Han Lee, Che-Chun Su, Lu Xia, Ronghui Peng, Jenq-Neng Hwang, Min Sun, and Cheng-Hao Kuo.
[ArXiv] [Paper] [Code]
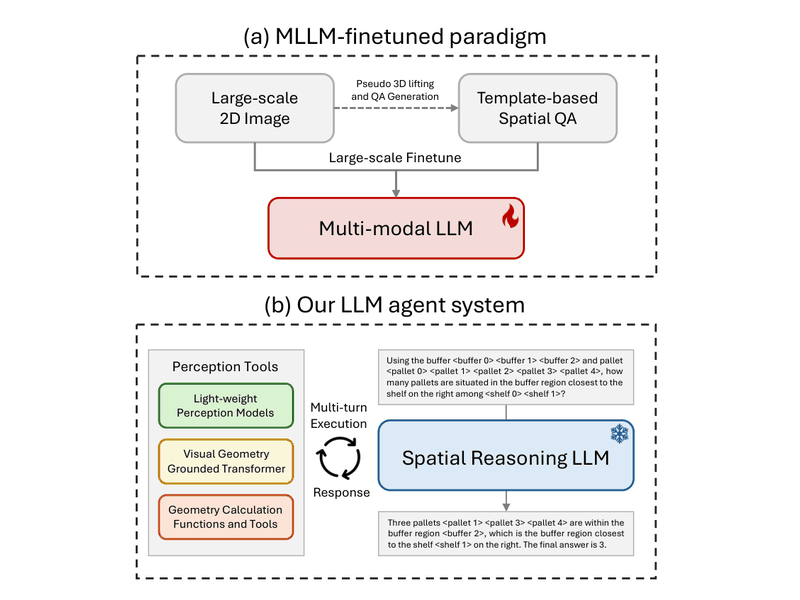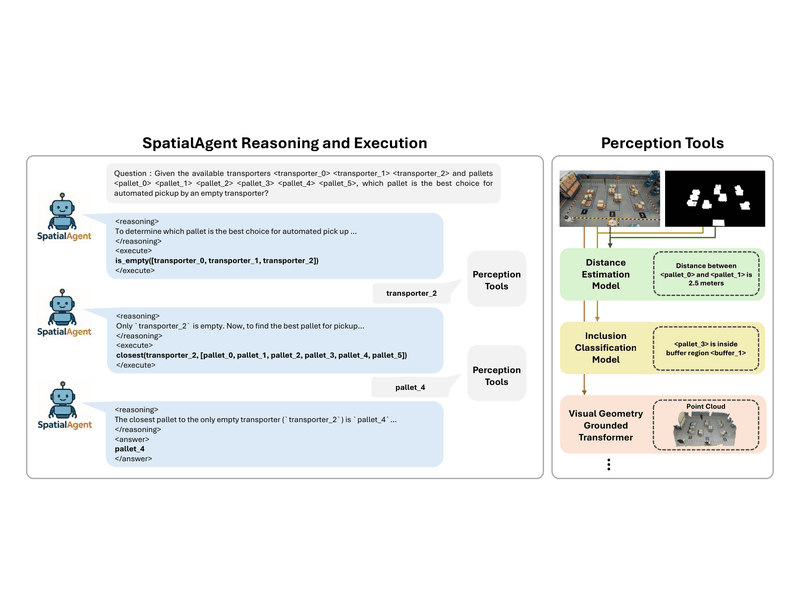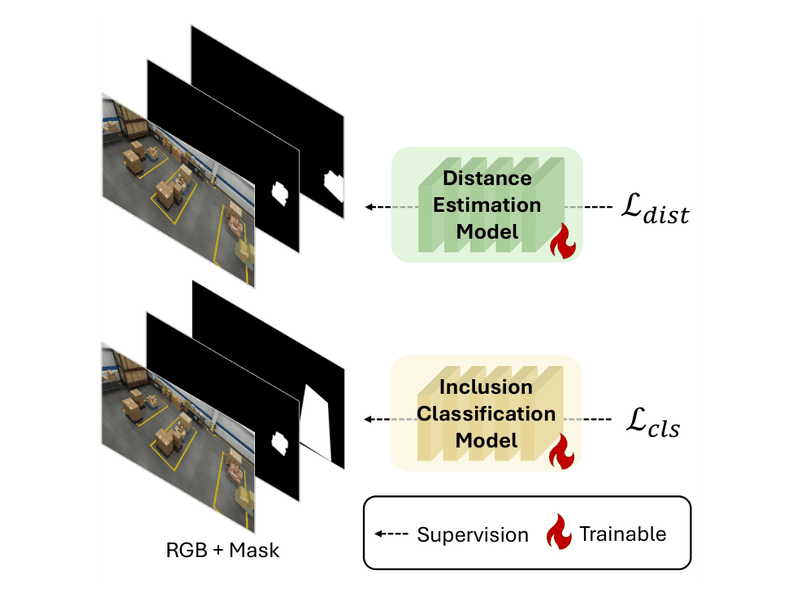 SpatialAgent: Spatial Question Answering with LLM Agent and Perception Models
IEEE MIPR (Best Student Paper Award), 2026.
Hsiang-Wei Huang, Junbin Lu, Pyongkun Kim, Jianxu Shangguan, Jen-Hao Cheng, Kuang-Ming Chen, et al.
[Paper] [Code]
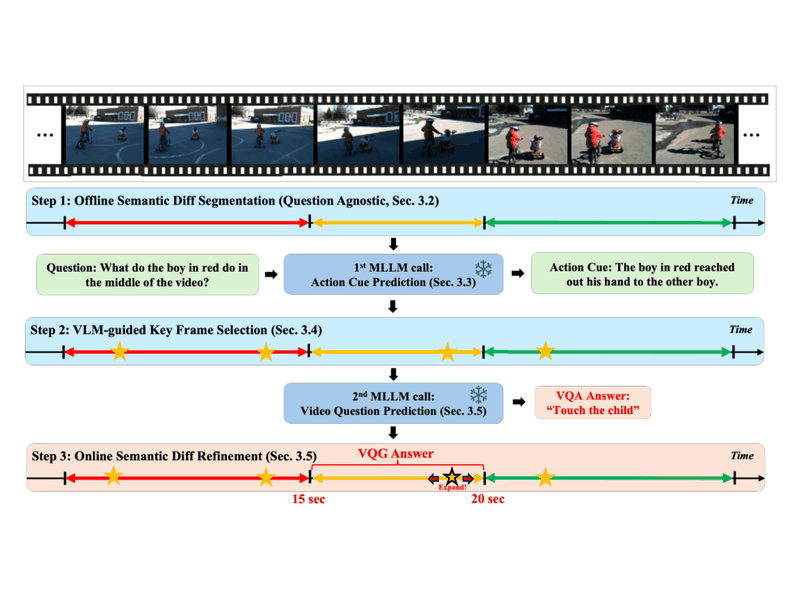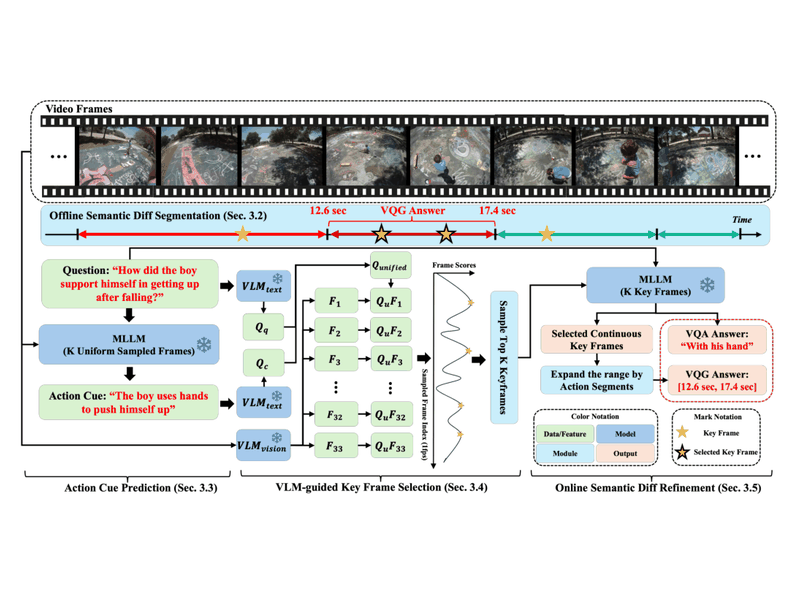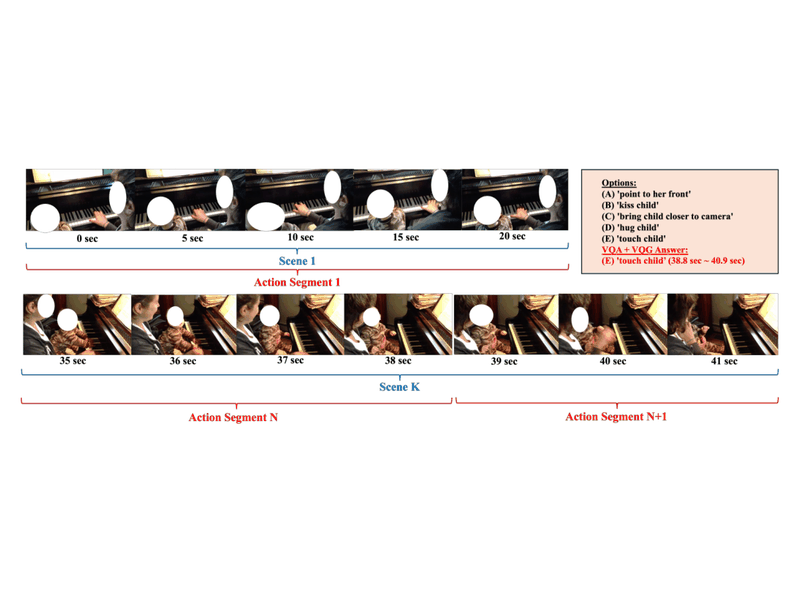 DiffGround: Semantic Difference-Guided Zero-Shot Video Question Grounding
Asian Conference on Computer Vision (ACCV), 2026.
Cheng-Han Lee, Amir Salimi, Hsiang-Wei Huang, Che-Chun Su, Min Sun, and Cheng-Hao Kuo.
[ArXiv]
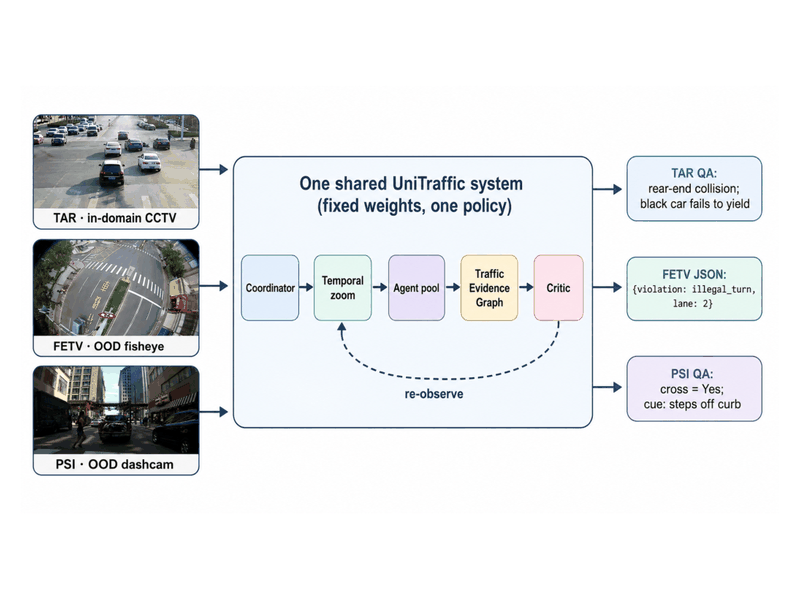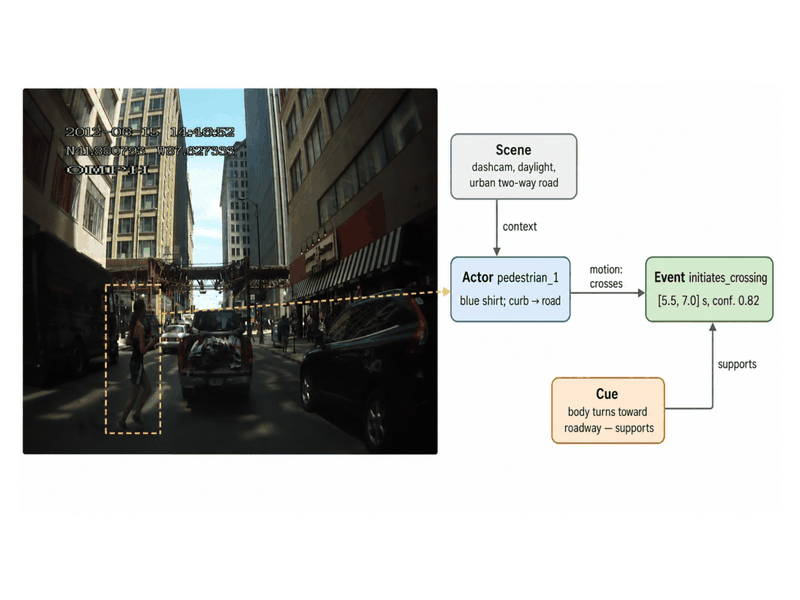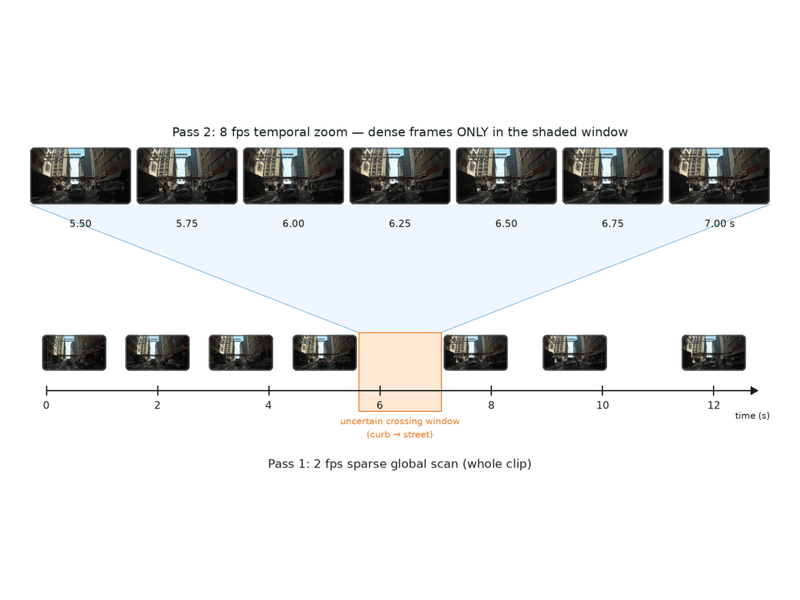 UniTraffic: Evidence-Centric Agentic Video Reasoning Across Traffic Anomalies, Violations, and Intent
ECCV AI City Challenge Workshop, 2026.
Jianxu Shangguan, Sangwon Kim, Hsiang-Wei Huang, Wei-Chieh Sun, Junbin Lu, et al.
[Code]
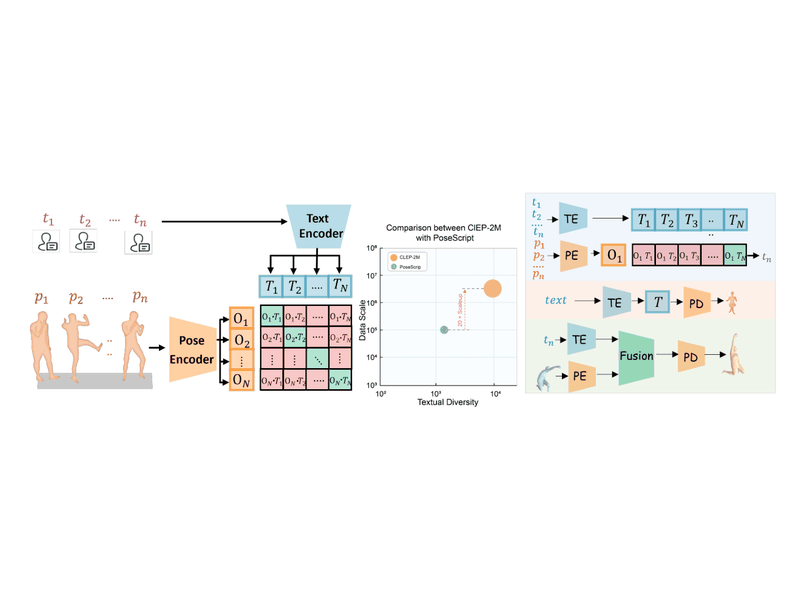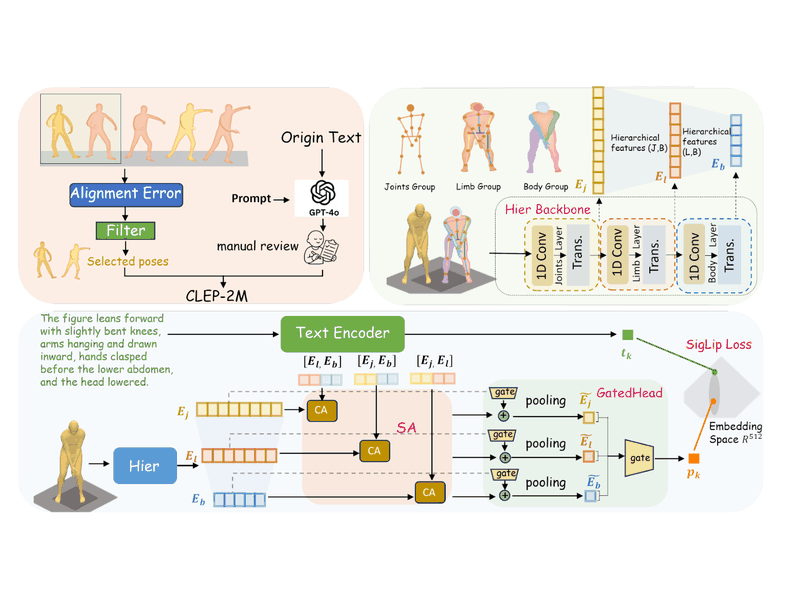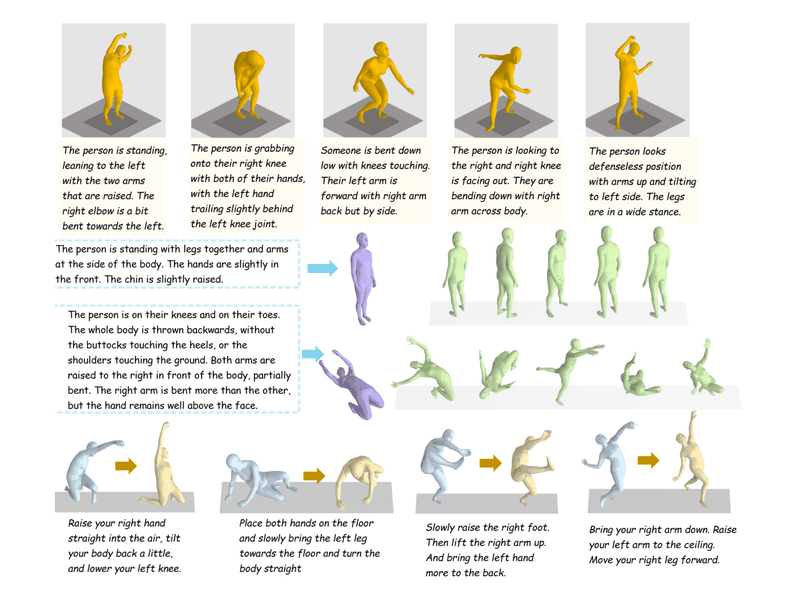 CLEP: Contrastive Language-Pose Pretraining
Computer Vision and Pattern Recognition (CVPR), 2026.
Sen Jia, Huayu Wang, Hsiang-Wei Huang, Zhaochong An, Jenq-Neng Hwang, Huaping Zhang, and Lei Li.
[Paper]
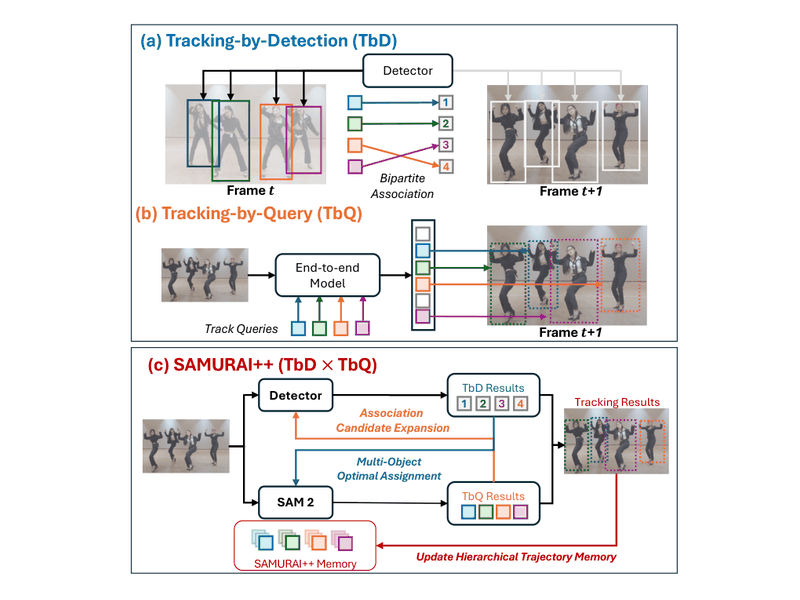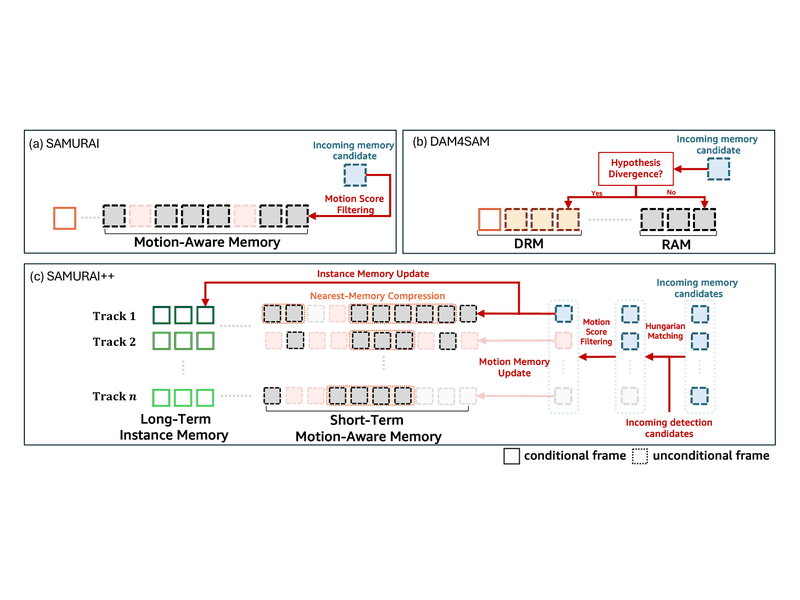 Extending Segment Anything Model 2 to Multi-Object Tracking by Optimizing Hierarchical Trajectory Memory
Computer Vision and Pattern Recognition (CVPR) Findings, 2026.
Cheng-Yen Yang, Hsiang-Wei Huang, Kuang-Ming Chen, Kunjun Li, and Jenq-Neng Hwang.
[Paper]
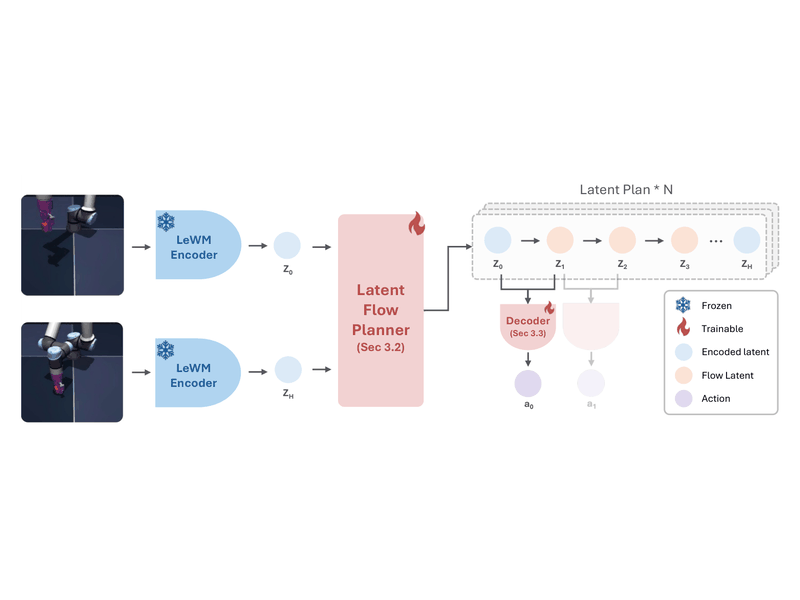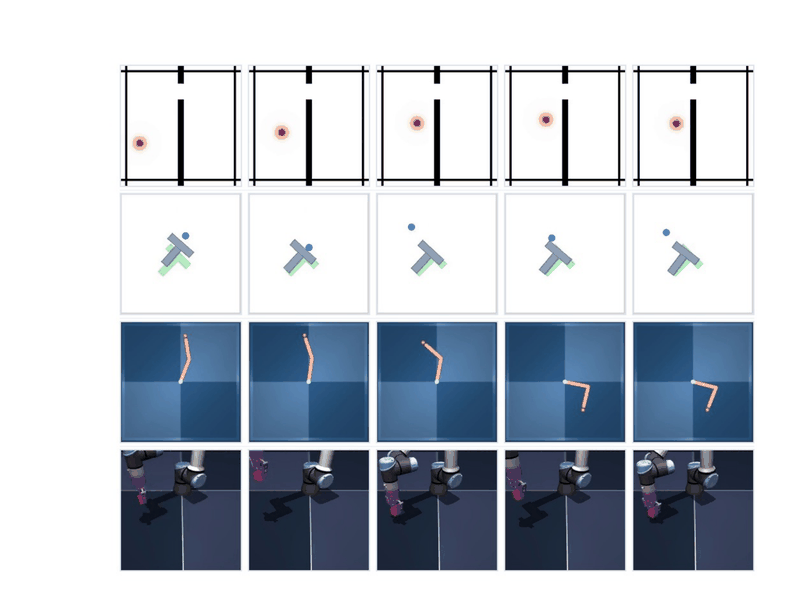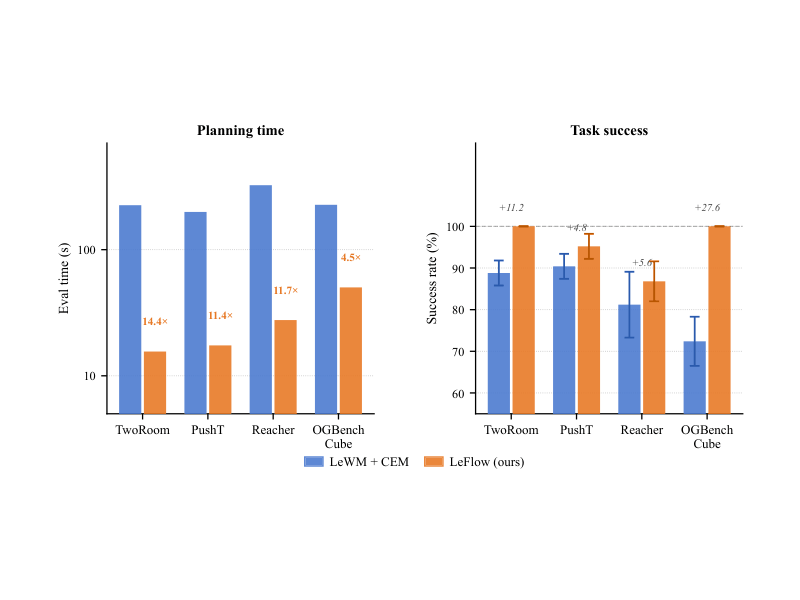 LeFlow: Generative Latent Flow Planning for World Models
ArXiv, 2026.
Hsiang-Wei Huang, Jianxu Shangguan, Junbin Lu, and Jenq-Neng Hwang.
[ArXiv] [Project Page] [Code]
 SAMURAI: Motion-Aware Memory for Training-Free Visual Object Tracking With SAM 2
IEEE Transactions on Image Processing (TIP), 2026.
Cheng-Yen Yang, Hsiang-Wei Huang, Wenhao Chai, Zhongyu Jiang, Jenq-Neng Hwang.
[Paper] [Project Page] [Code] [Youtube]
 Warehouse Spatial Question Answering with LLM Agent
ICCV AI City Challenge Workshop (1st Place Solution of AI City Challenge Track 3), 2025.
Hsiang-Wei Huang, Jen-Hao Cheng, Kuang-Ming Chen, Cheng-Yen Yang, Bahaa Alattar, Yi-Ru Lin, Pyongkun Kim, Sangwon Kim, Kwangju Kim, Chung-I Huang, and Jenq-Neng Hwang.
[ArXiv] [Paper] [Code]
 ToSA: Token Merging with Spatial Awareness
IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS) Oral, 2025.
Hsiang-Wei Huang, Wenhao Chai, Kuang-Ming Chen, Cheng-Yen Yang, and Jenq-Neng Hwang.
[ArXiv] [Paper] [Code]
 Zero-shot 3D Question Answering via Voxel-based Dynamic Token Compression
Computer Vision and Pattern Recognition (CVPR), 2025.
Hsiang-Wei Huang, Fu-Chen Chen, Wenhao Chai, Che-Chun Su, Lu Xia, Sanghun Jung, Cheng-Yen Yang, Jenq-Neng Hwang, Min Sun, Cheng-hao Kuo.
[Paper]
 MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking
International Conference on Acoustics, Speech, and Signal Processing (ICASSP) Oral, 2025.
Hsiang-Wei Huang, Cheng-Yen Yang, Wenhao Chai, Zhongyu Jiang, Jenq-Neng Hwang.
[Paper]
 GTA: Global Tracklet Association for Multi-Object Tracking in Sports
ACCV Workshop, 2024.
Jiacheng Sun, Hsiang-Wei Huang, Cheng-Yen Yang, Zhongyu Jiang, Jenq-Neng Hwang.
[Paper] [Code]
 RT-Pose: A 4D Radar Tensor-based 3D Human Pose Estimation and Localization Benchmark
European Conference on Computer Vision (ECCV), 2024.
Yuan-Hao Ho, Jen-Hao Cheng, Sheng Yao Kuan, Zhongyu Jiang, Wenhao Chai, Hsiang-Wei Huang, Chih-Lung Lin, Jenq-Neng Hwang.
[Paper] [Code]
 ToddlerAct: A Toddler Action Recognition Dataset for Gross Motor Development Assessment
ECCV Workshop, 2024.
Hsiang-Wei Huang, Jiacheng Sun, Cheng-Yen Yang, Zhongyu Jiang, Jenq-Neng Hwang, Yu-Ching Yeh.
[Paper]
 An Online Approach and Evaluation Method for Tracking People Across Cameras in Extremely Long Video Sequences
CVPR Workshop, 2024.
Cheng-Yen Yang, Hsiang-Wei Huang, Pyong-Kun Kim, Zhongyu Jiang, Kwang-Ju Kim, Chung-I Huang, Haiqing Du, Jenq-Neng Hwang.
[Paper]
 Boosting Online 3D Multi-Object Tracking through Camera-Radar Cross Check
IEEE Intelligent Vehicles Symposium (IV), 2024.
Sheng-Yao Kuan, Jen-Hao Cheng, Hsiang-Wei Huang, Wenhao Chai, Cheng-Yen Yang, Hugo Latapie, Gaowen Liu, Bing-Fei Wu, Jenq-Neng Hwang.
[Paper]
 A Density-Guided Temporal Attention Transformer for Indiscernible Object Counting in Underwater Videos
International Conference on Acoustics, Speech, and Signal Processing (ICASSP), 2024.
Cheng-Yen Yang, Hsiang-Wei Huang, Zhongyu Jiang, Jenq-Neng Hwang.
[Paper]
 Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports
WACV Workshop, 2024.
Hsiang-Wei Huang, Cheng-Yen Yang, Jiacheng Sun, Pyong-Kun Kim, Kwang-Ju Kim, Kyoungoh Lee, Chung-I Huang, Jenq-Neng Hwang.
[Paper] [Code]
 Sea You Later: Metadata-Guided Long-Term Re-Identification for UAV-Based Multi-Object Tracking
WACV Workshop, 2024.
Cheng-Yen Yang, Hsiang-Wei Huang, Zhongyu Jiang, Heng-Cheng Kuo, Jie Mei, Chung-I Huang, Jenq-Neng Hwang.
[Paper]
 Enhancing Multi-Camera People Tracking with Anchor-Guided Clustering and Spatio-Temporal Consistency ID Re-Assignment
CVPR Workshop, 2023.
Hsiang-Wei Huang, Cheng-Yen Yang, Zhongyu Jiang, Pyong-Kun Kim, Kyoungoh Lee, Kwangju Kim, Chung-I Huang, Jenq-Neng Hwang.
[Paper] [Demo] [Code]
 Observation Centric and Central Distance Recovery for Athlete Tracking
WACV Workshop, 2023.
Hsiang-Wei Huang, Cheng-Yen Yang, Samartha Ramkumar, Chung-I Huang, Jenq-Neng Hwang, Pyong-Kun Kim, Kyoungoh Lee, Kwangju Kim.
[Paper] [Demo]